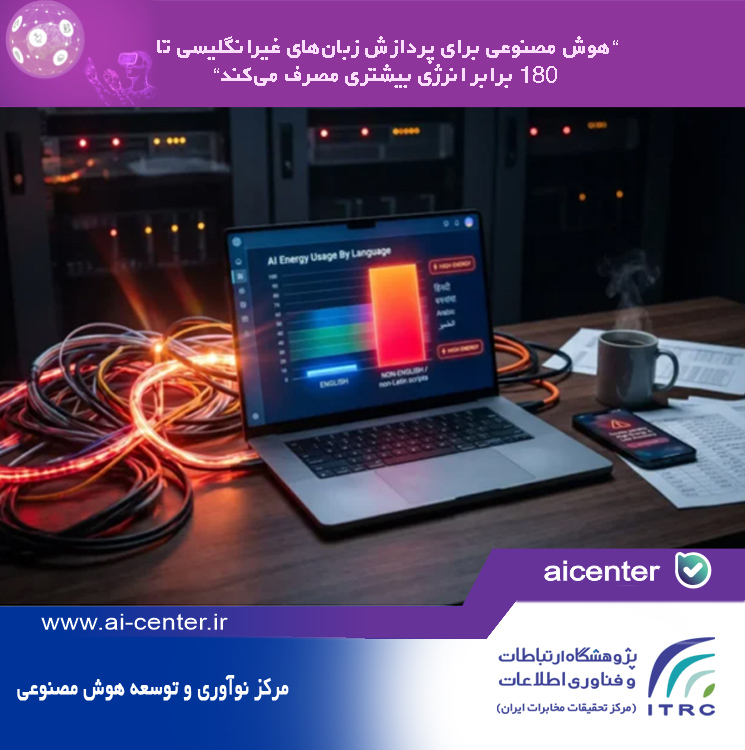
پژوهش جدید محققان دانشگاه میشیگان نشان میدهد مدلهای هوش مصنوعی مولد هنگام پردازش و تولید متن به زبانهایی غیر از انگلیسی، انرژی بسیار بیشتری مصرف میکنند؛ اختلافی که در برخی موارد به ۱۸۰ برابر میرسد.
این پژوهش با عنوان «شکاف زبان و انرژی» (The Language-Energy Divide) و با بررسی سه مدل متنباز Qwen 3، Gemma 3 و Llama 3.1 انجام شده است. محققان برای ارزیابی عملکرد مدلها از مجموعهدادهای استفاده کردند که دربرگیرنده ۱۲۲ زبان مختلف است.
یکی از دلایل اصلی این اختلاف، تعداد توکنهای موردنیاز برای پردازش متن است. مدلهای هوش مصنوعی برای نمایش برخی زبانها، بهویژه زبانهایی با خط نوشتاری پیچیدهتر و دادههای آموزشی دیجیتال محدودتر، به توکنهای بیشتری نیاز دارند.
افزایش تعداد توکنها نیز باعث مصرف بیشتر حافظه و افزایش هزینه محاسباتی میشود.
برای مثال، طبق نتایج این پژوهش، پردازش متنی به زبان هندی ۷.۹ برابر و زبان بنگالی ۱۵.۳ برابر بیشتر از متن مشابه انگلیسی انرژی مصرف میکند.
یافتهها نشان میدهد حدود ۵.۲ میلیارد نفر در جهان برای تولید متن به زبان مادری خود، با مصرف انرژی بیش از دو برابر نسبت به کاربران انگلیسیزبان مواجهاند.
این مسئله علاوه بر افزایش هزینه استفاده از هوش مصنوعی، میتواند کیفیت پاسخها را نیز کاهش دهد؛ زیرا پژوهشگران دریافتند زبانهایی که مصرف انرژی بیشتری دارند، در برخی موارد با دقت پاسخگویی پایینتری همراه هستند.
محققان پیشنهاد میکنند شرکتهای توسعهدهنده هوش مصنوعی با آموزش مدلهای تخصصی برای زبانهای مختلف و افزایش دادههای آموزشی غیرانگلیسی، این شکاف را کاهش دهند.
این پژوهش بار دیگر نشان میدهد توسعه هوش مصنوعی چندزبانه تنها به ترجمه و پشتیبانی از زبانهای مختلف محدود نمیشود و بهینهسازی مصرف انرژی و کیفیت پاسخگویی نیز از چالشهای مهم آن است.
کد خبر ۲۱۲۰۵۰۸۲۵.۷۶۸
منبع: بیو اینجیرینگ